---
title: DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16
canonical_url: "https://www.modelscope.cn/models/okwinds/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16"
md_url: "https://www.modelscope.cn/models/okwinds/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16.md"
repository: okwinds/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16
chinese_name: "DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16 量化高精校准"
last_updated: 2025-04-17
license: "Apache License 2.0"
pipeline_tag: text-generation
tasks:
- text-generation
model_type:
- qwen2
architectures:
- Qwen2ForCausalLM
base_model:
- deepseek-ai/DeepSeek-R1-Distill-Qwen-7B
base_model_relation: quantized
parameters: 2.0B
tensor_type:
- BF16
- I32
- I64
library_name:
- safetensors
- pytorch
frameworks:
- Pytorch
language:
- en
- cn
inference_backends:
- "deploy_task text/emb"
- "lmdeploy 0.9.1"
- "lmdeploy_turbomind 0.9.1"
- "sglang 0.5.2"
- "vllm 0.9.2"
downloads: 375032
stars: 7
tags:
- Chat
- Instruct
- fine-tuned
---
# DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16
> DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16 - okwinds 在 ModelScope 开源的模型。DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16 量化高精校准
okwinds/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16 是 ModelScope 魔搭社区上的 2.0B 参数text-generation模型,采用 Apache License 2.0 许可,基于 deepseek-ai/DeepSeek-R1-Distill-Qwen-7B 构建,可用 deploy_task text/emb、lmdeploy 0.9.1、lmdeploy_turbomind 0.9.1 部署。
- **Repository**: okwinds/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16
- **License**: Apache License 2.0
- **Tasks**: text-generation
- **Parameters**: 2.0B
- **Base model**: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B
- **Inference backends**: deploy_task text/emb, lmdeploy 0.9.1, lmdeploy_turbomind 0.9.1, sglang 0.5.2, vllm 0.9.2
- **Tags**: Chat, Instruct, fine-tuned
- **Downloads**: 375032
- **Stars**: 7
- **Last updated**: 2025-04-17
Source: https://www.modelscope.cn/models/okwinds/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16
---
# DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16 量化高精校准
### 原模型解读,请看公众号文章 👇🏻
###  觉察流 - [DeepSeek-R1挑战OpenAI,AI推理模型的新时代来临](https://mp.weixin.qq.com/s/mG18W607Xxt_lp_6NhNPAw)
友情提醒,推理本模型时,请按照如下官方指引:
> 注意:建议在运行这些模型时设置适当的温度(0.5 到 0.7 之间),否则您可能会遇到无休止的重复或不连贯的输出问题。
📖 关于量化损失方面的研究,可阅读公众号“觉察流”文章👇
《[Reason Model 的“瘦身计划”:量化技术的得与失](https://mp.weixin.qq.com/s/NMGq4UUkfo8GMix5LHnWCg)》
#### _仓库作者在此 👇🏻 扫一扫_
 _______________________________
# 下载方法
SDK下载
```bash
#安装ModelScope
pip install modelscope
```
```python
#SDK模型下载
from modelscope import snapshot_download
model_dir = snapshot_download('okwinds/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16')
```
Git下载
```
#Git模型下载
git clone https://www.modelscope.cn/okwinds/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16.git
```
# 模型概述
DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16 是一个基于 [deepseek-ai/DeepSeek-R1-Distill-Qwen-7B](https://www.modelscope.cn/models/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B) 的 Int4 量化的模型。
- **模型名称:** DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16
- **模型架构:** Qwen2.5
- **权重量化:** Int4
## 量化模型
该模型通过将 [deepseek-ai/DeepSeek-R1-Distill-Qwen-7B](https://www.modelscope.cn/models/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B) 的权重量化为 Int4 数据类型而实现。
量化过程将每个参数从 16bit 减少到 4bit,将模型占用磁盘空间大小,以及推理时加载模型需要的GPU显存空间,减少到了大约为原模型的1/4。只有 transformer 中的 Linear 层权重是量化的,其他层均保持为原模型数据类型,采用了混合精度的计算方式,尽可能减少模型量化后所带来的精度损失。
量化本模型,使用了[AutoGPTQ](https://github.com/AutoGPTQ/AutoGPTQ),采用 Symmetric group-wise 方式量化(group size : 128)。并在量化过程中,进行了数据校准,以提升模型生成精度。
> 注意:本模型需要 compute capability > 8.0(Ampere、Ada Lovelace、Hopper 架构)的 Nvidia GPU 来支持 INT4 **混合精度**计算。
# 部署推理
### 推荐使用 vLLM ( version > 0.6.6.post1 )
Openai api 兼容模式
```bash
>>> vllm serve "/home/gavin/llm/DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16" --host 0.0.0.0 --port 8000 --gpu-memory-utilization 0.9 --served-model-name "DeepSeek-R1-Distill-Qwen-7B-Int4-W4A16"
```
---
以下引自原模型的Model Card
## 1. 引言
我们推出第一代推理模型 DeepSeek-R1-Zero 和 DeepSeek-R1。
DeepSeek-R1-Zero 是一种通过大规模强化学习(Reinforcement Learning, RL)训练的模型,训练过程中未使用监督微调(Supervised Fine-Tuning, SFT)作为前置步骤,但在推理任务上表现出色。
借助 RL,DeepSeek-R1-Zero 自然地展现出许多强大且有趣的推理行为。然而,DeepSeek-R1-Zero 也面临一些挑战,例如无休止的重复、可读性差以及语言混合等问题。
为解决这些问题并进一步提升推理性能,我们推出了 DeepSeek-R1,该模型在 RL 之前引入了冷启动数据(cold-start data)。
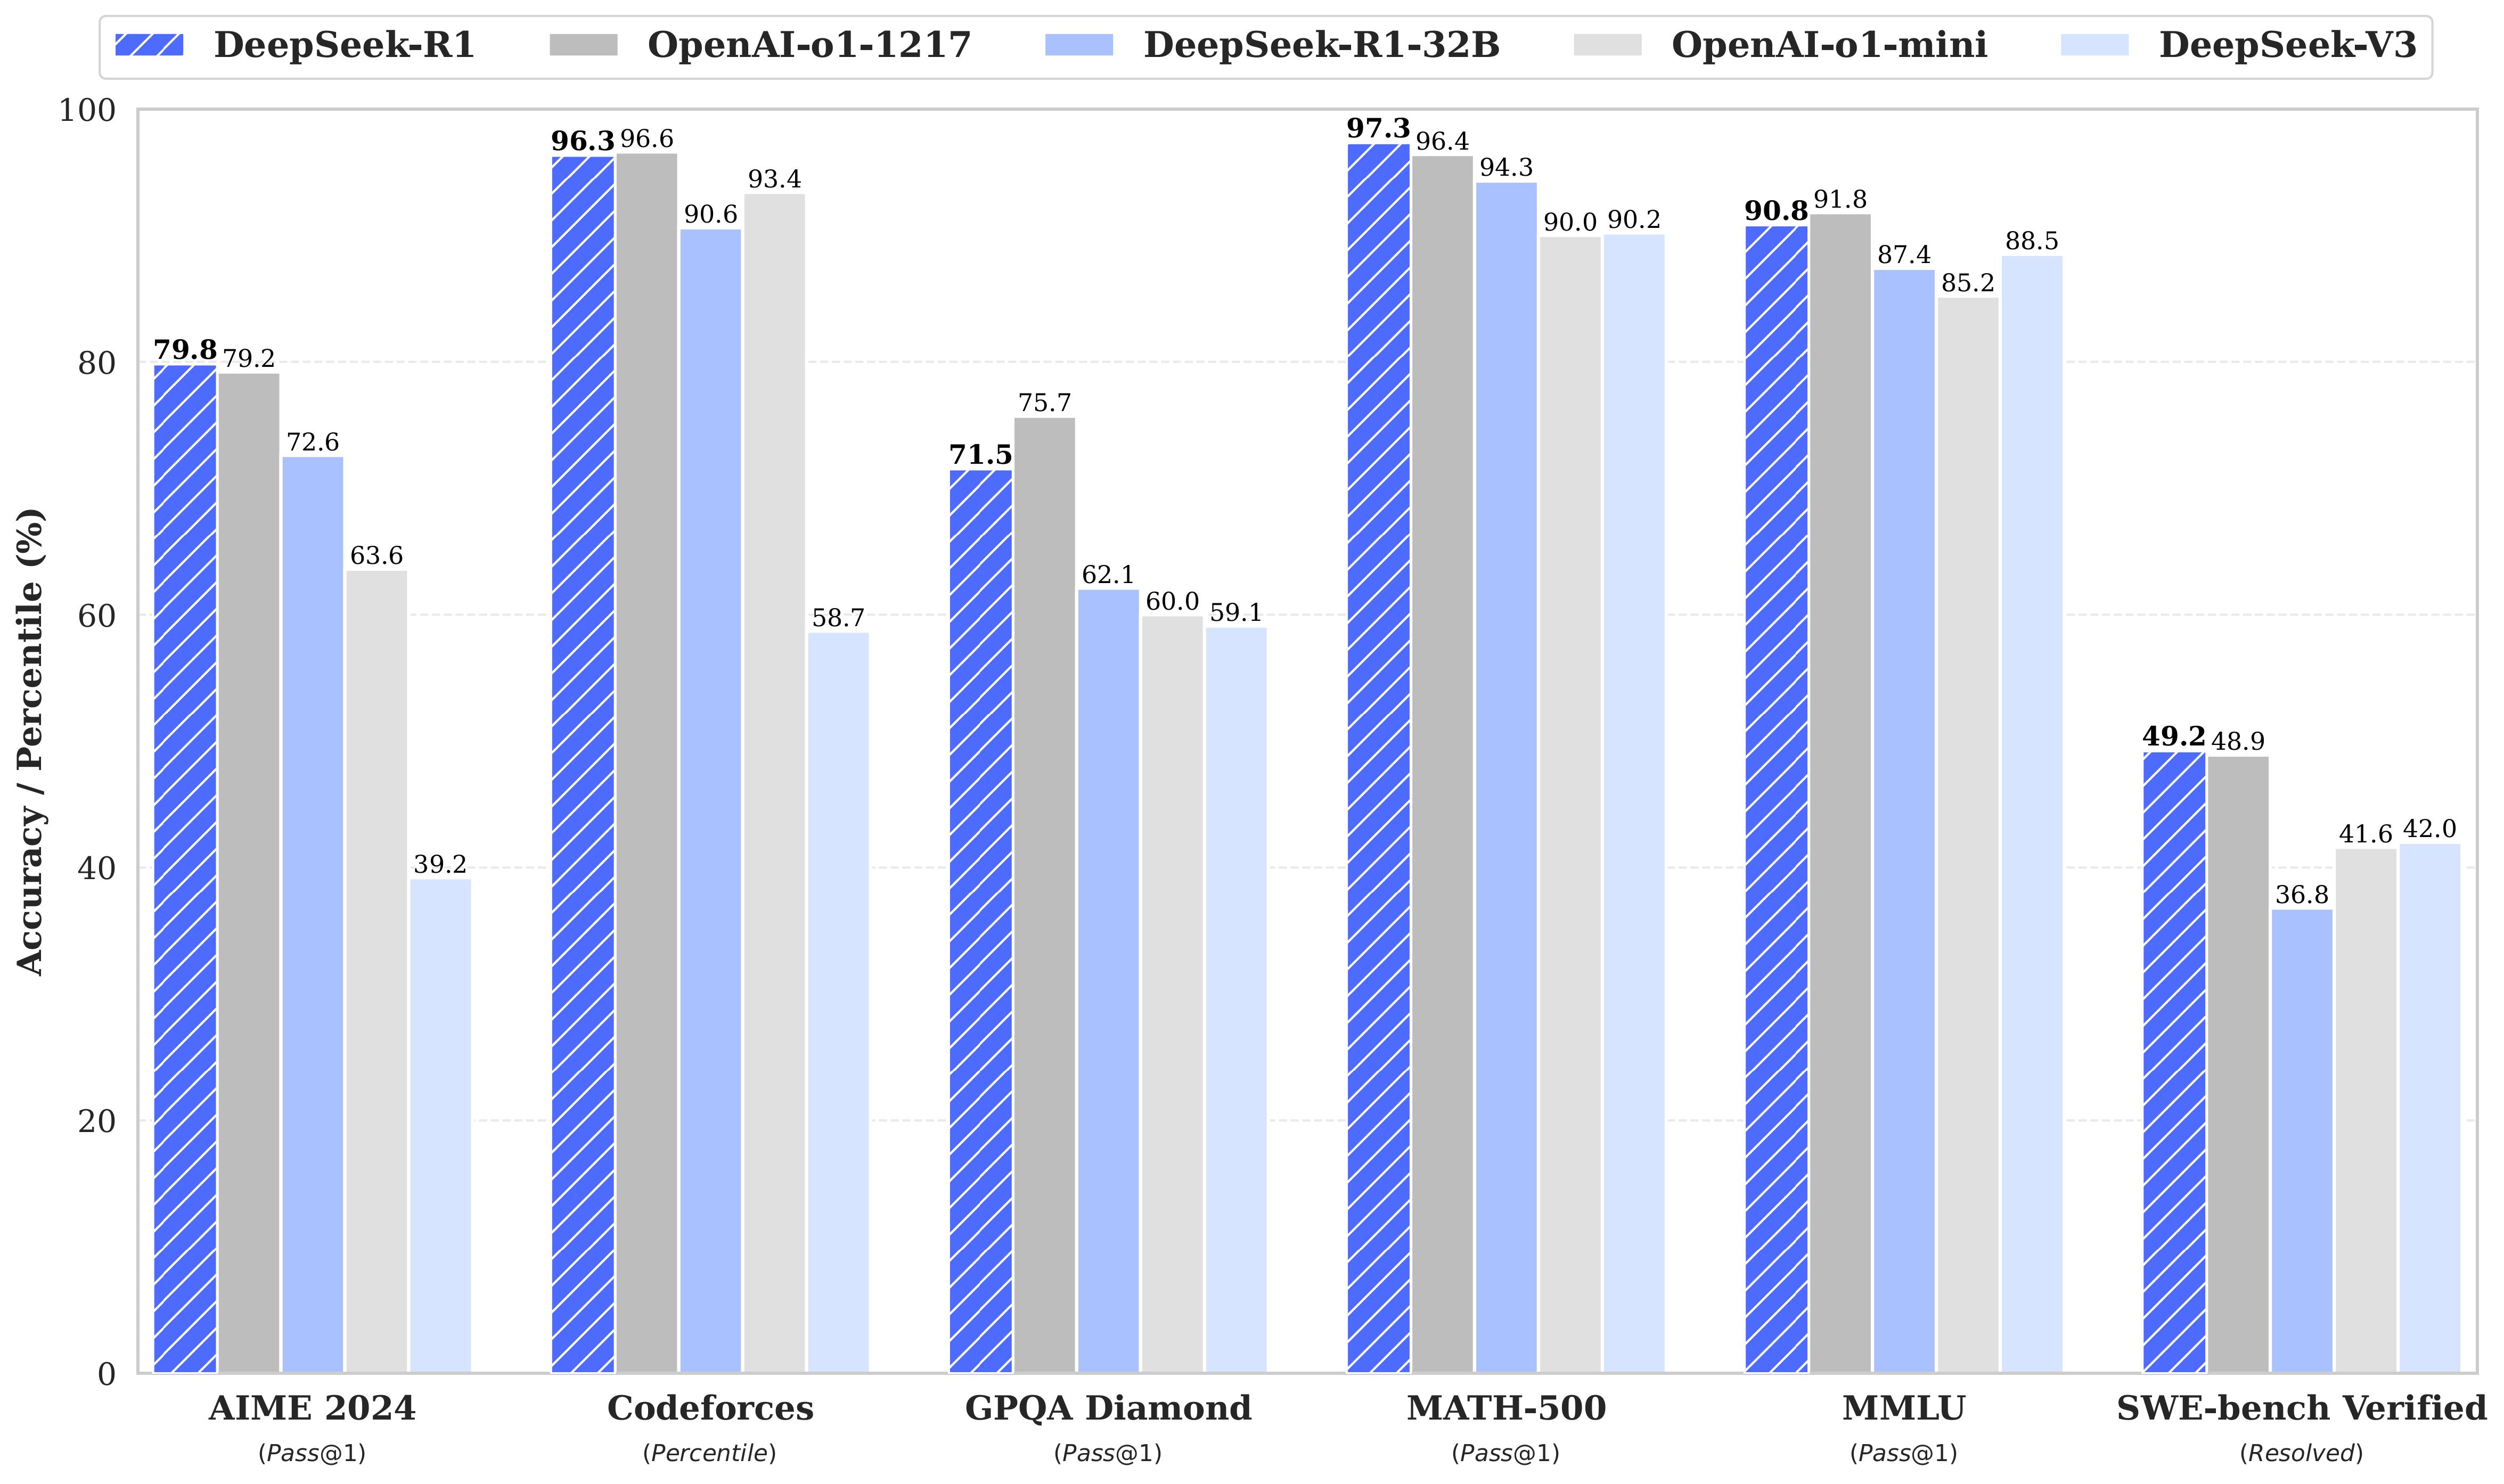
DeepSeek-R1 在数学、编程和推理任务上的表现与 OpenAI-o1 相当。
为了支持研究社区,我们开源了 DeepSeek-R1-Zero、DeepSeek-R1,以及基于 Llama 和 Qwen 系列从 DeepSeek-R1 蒸馏出的六个Dense模型。
其中,DeepSeek-R1-Distill-Qwen-32B 在多个基准测试中超越了 OpenAI-o1-mini,为密集模型创造了新的最佳性能。
## 2. 模型概述
后训练:在基础模型上进行大规模强化学习
- 我们直接在基础模型上应用强化学习(RL),而不依赖于监督微调(SFT)作为前置步骤。
这种方法使模型能够探索用于解决复杂问题的思维链(Chain-of-Thought, CoT),从而开发出 DeepSeek-R1-Zero。
DeepSeek-R1-Zero 展示了自我验证、反思和生成长思维链的能力,这标志着研究社区的一个重要里程碑。
值得注意的是,它是首次公开研究验证,通过纯 RL 激励大型语言模型(LLMs)的推理能力,无需 SFT。
这一突破为该领域的未来发展铺平了道路。
- 我们介绍了开发 DeepSeek-R1 的流程。该流程包括两个 RL 阶段,旨在发现改进的推理模式并符合人类偏好,以及两个 SFT 阶段,作为模型推理和非推理能力的种子。
我们相信这一流程将有助于行业开发更好的模型。
蒸馏:小模型也可以很强大
- 我们证明了可以将大模型的推理模式蒸馏到小模型中,与通过小模型上的 RL 发现的推理模式相比,性能更好。开源的 DeepSeek-R1 及其 API 将有助于研究社区在未来蒸馏出更好的小模型。
- 使用 DeepSeek-R1 生成的推理数据,我们微调了几个在研究社区中广泛使用的密集模型。评估结果表明,这些蒸馏后的小密集模型在基准测试中表现出色。我们基于 Qwen2.5 和 Llama3 系列开源了 1.5B、7B、8B、14B、32B 和 70B 的检查点,供社区使用。
DeepSeek-R1-Distill 模型是基于开源模型微调的,使用 DeepSeek-R1 生成的样本进行训练。我们对其配置和分词器进行了小幅调整。请使用我们的设置运行这些模型。
## 3. 评估结果
DeepSeek-R1 评估
对于所有模型,最大生成长度设置为 32,768 个Token。对于需要采样的基准测试,我们使用温度为 0.6、top-p 值为 0.95,并为每个查询生成 64 个响应以估计 pass@1。
| Category | Benchmark (Metric) | Claude-3.5-Sonnet-1022 | GPT-4o 0513 | DeepSeek V3 | OpenAI o1-mini | OpenAI o1-1217 | DeepSeek R1 |
|----------|-------------------|----------------------|------------|--------------|----------------|------------|--------------|
| | Architecture | - | - | MoE | - | - | MoE |
| | # Activated Params | - | - | 37B | - | - | 37B |
| | # Total Params | - | - | 671B | - | - | 671B |
| English | MMLU (Pass@1) | 88.3 | 87.2 | 88.5 | 85.2 | **91.8** | 90.8 |
| | MMLU-Redux (EM) | 88.9 | 88.0 | 89.1 | 86.7 | - | **92.9** |
| | MMLU-Pro (EM) | 78.0 | 72.6 | 75.9 | 80.3 | - | **84.0** |
| | DROP (3-shot F1) | 88.3 | 83.7 | 91.6 | 83.9 | 90.2 | **92.2** |
| | IF-Eval (Prompt Strict) | **86.5** | 84.3 | 86.1 | 84.8 | - | 83.3 |
| | GPQA-Diamond (Pass@1) | 65.0 | 49.9 | 59.1 | 60.0 | **75.7** | 71.5 |
| | SimpleQA (Correct) | 28.4 | 38.2 | 24.9 | 7.0 | **47.0** | 30.1 |
| | FRAMES (Acc.) | 72.5 | 80.5 | 73.3 | 76.9 | - | **82.5** |
| | AlpacaEval2.0 (LC-winrate) | 52.0 | 51.1 | 70.0 | 57.8 | - | **87.6** |
| | ArenaHard (GPT-4-1106) | 85.2 | 80.4 | 85.5 | 92.0 | - | **92.3** |
| Code | LiveCodeBench (Pass@1-COT) | 33.8 | 34.2 | - | 53.8 | 63.4 | **65.9** |
| | Codeforces (Percentile) | 20.3 | 23.6 | 58.7 | 93.4 | **96.6** | 96.3 |
| | Codeforces (Rating) | 717 | 759 | 1134 | 1820 | **2061** | 2029 |
| | SWE Verified (Resolved) | **50.8** | 38.8 | 42.0 | 41.6 | 48.9 | 49.2 |
| | Aider-Polyglot (Acc.) | 45.3 | 16.0 | 49.6 | 32.9 | **61.7** | 53.3 |
| Math | AIME 2024 (Pass@1) | 16.0 | 9.3 | 39.2 | 63.6 | 79.2 | **79.8** |
| | MATH-500 (Pass@1) | 78.3 | 74.6 | 90.2 | 90.0 | 96.4 | **97.3** |
| | CNMO 2024 (Pass@1) | 13.1 | 10.8 | 43.2 | 67.6 | - | **78.8** |
| Chinese | CLUEWSC (EM) | 85.4 | 87.9 | 90.9 | 89.9 | - | **92.8** |
| | C-Eval (EM) | 76.7 | 76.0 | 86.5 | 68.9 | - | **91.8** |
| | C-SimpleQA (Correct) | 55.4 | 58.7 | **68.0** | 40.3 | - | 63.7 |
蒸馏模型评估
| Model | AIME 2024 pass@1 | AIME 2024 cons@64 | MATH-500 pass@1 | GPQA Diamond pass@1 | LiveCodeBench pass@1 | CodeForces rating |
|------------------------------------------|------------------|-------------------|-----------------|----------------------|----------------------|-------------------|
| GPT-4o-0513 | 9.3 | 13.4 | 74.6 | 49.9 | 32.9 | 759 |
| Claude-3.5-Sonnet-1022 | 16.0 | 26.7 | 78.3 | 65.0 | 38.9 | 717 |
| o1-mini | 63.6 | 80.0 | 90.0 | 60.0 | 53.8 | **1820** |
| QwQ-32B-Preview | 44.0 | 60.0 | 90.6 | 54.5 | 41.9 | 1316 |
| DeepSeek-R1-Distill-Qwen-1.5B | 28.9 | 52.7 | 83.9 | 33.8 | 16.9 | 954 |
| DeepSeek-R1-Distill-Qwen-7B | 55.5 | 83.3 | 92.8 | 49.1 | 37.6 | 1189 |
| DeepSeek-R1-Distill-Qwen-14B | 69.7 | 80.0 | 93.9 | 59.1 | 53.1 | 1481 |
| DeepSeek-R1-Distill-Qwen-32B | **72.6** | 83.3 | 94.3 | 62.1 | 57.2 | 1691 |
| DeepSeek-R1-Distill-Llama-8B | 50.4 | 80.0 | 89.1 | 49.0 | 39.6 | 1205 |
| DeepSeek-R1-Distill-Llama-70B | 70.0 | **86.7** | **94.5** | **65.2** | **57.5** | 1633 |
## 4. 聊天网站和 API 平台
您可以在 DeepSeek 官方网站 chat.deepseek.com 上与 DeepSeek-R1 进行对话,并打开 “深度思考” 按钮。
我们还在 DeepSeek 平台提供 OpenAI 兼容的 API:platform.deepseek.com。
## 5. 如何本地运行
DeepSeek-R1 模型
请访问 DeepSeek-V3 仓库,了解有关本地运行 DeepSeek-R1 的更多信息。
DeepSeek-R1-Distill 模型
DeepSeek-R1-Distill 模型的使用方式与 Qwen 或 Llama 模型相同。
例如,您可以使用 vLLM 轻松启动服务:
```Shell
vllm serve deepseek-ai/DeepSeek-R1-Distill-Qwen-7B --tensor-parallel-size 2 --max-model-len 32768 --enforce-eager
```
注意:我们建议在运行这些模型时设置适当的温度(0.5 到 0.7 之间),否则您可能会遇到无休止的重复或不连贯的输出问题。
6. 许可
本代码仓库和模型权重均在 MIT License 下授权。DeepSeek-R1 系列支持商业用途,允许进行任何修改和衍生作品,包括但不限于用于训练其他大型语言模型(LLMs)的蒸馏。请注意:
- DeepSeek-R1-Distill-Qwen-1.5B、DeepSeek-R1-Distill-Qwen-7B、DeepSeek-R1-Distill-Qwen-14B 和 DeepSeek-R1-Distill-Qwen-32B 均基于 Qwen-2.5 系列,最初在 Apache 2.0 License 下授权,现已使用 DeepSeek-R1 精选的 800k 样本进行微调。
- DeepSeek-R1-Distill-Llama-8B 基于 Llama3.1-8B-Base,最初在 llama3.1 许可证 下授权。
- DeepSeek-R1-Distill-Llama-70B 基于 Llama3.3-70B-Instruct,最初在 llama3.3 许可证 下授权。