---
title: DeepSeek-R1-Distill-Qwen-32B-MLX-6bit
canonical_url: "https://www.modelscope.cn/models/okwinds/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit"
md_url: "https://www.modelscope.cn/models/okwinds/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit.md"
repository: okwinds/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit
last_updated: 2025-01-22
license: "Apache License 2.0"
pipeline_tag: text-generation
tasks:
- text-generation
model_type:
- qwen2
architectures:
- Qwen2ForCausalLM
base_model:
- deepseek-ai/DeepSeek-R1-Distill-Qwen-32B
base_model_relation: quantized
parameters: 7.2B
tensor_type:
- F16
- U32
library_name:
- mlx
- safetensors
- pytorch
frameworks:
- Pytorch
language:
- en
- cn
inference_backends:
- "deploy_task text/emb"
- "lmdeploy 0.9.1"
- "lmdeploy_turbomind 0.9.1"
- "sglang 0.5.2"
- "vllm 0.9.2"
downloads: 148
stars: 3
tags:
- Chat
- Instruct
- fine-tuned
- MLX
---
# DeepSeek-R1-Distill-Qwen-32B-MLX-6bit
> DeepSeek-R1-Distill-Qwen-32B-MLX-6bit - okwinds 在 ModelScope 开源的模型。DeepSeek-R1-Distill-Qwen-32B-MLX-6bit
okwinds/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit 是 ModelScope 魔搭社区上的 7.2B 参数text-generation模型,采用 Apache License 2.0 许可,基于 deepseek-ai/DeepSeek-R1-Distill-Qwen-32B 构建,可用 deploy_task text/emb、lmdeploy 0.9.1、lmdeploy_turbomind 0.9.1 部署。
- **Repository**: okwinds/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit
- **License**: Apache License 2.0
- **Tasks**: text-generation
- **Parameters**: 7.2B
- **Base model**: deepseek-ai/DeepSeek-R1-Distill-Qwen-32B
- **Inference backends**: deploy_task text/emb, lmdeploy 0.9.1, lmdeploy_turbomind 0.9.1, sglang 0.5.2, vllm 0.9.2
- **Tags**: Chat, Instruct, fine-tuned, MLX
- **Downloads**: 148
- **Stars**: 3
- **Last updated**: 2025-01-22
Source: https://www.modelscope.cn/models/okwinds/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit
---
# DeepSeek-R1-Distill-Qwen-32B-MLX-6bit
### 原模型解读,请看公众号文章 👇🏻
###  觉察流 - [DeepSeek-R1挑战OpenAI,AI推理模型的新时代来临](https://mp.weixin.qq.com/s/mG18W607Xxt_lp_6NhNPAw)
友情提醒,推理本模型时,请按照如下官方指引:
> 注意:建议在运行这些模型时设置适当的温度(0.5 到 0.7 之间),否则您可能会遇到无休止的重复或不连贯的输出问题。
#### _仓库作者在此 👇🏻 扫一扫_
 _______________________________
# 下载方法
SDK下载
```bash
#安装ModelScope
pip install modelscope
```
```python
#SDK模型下载
from modelscope import snapshot_download
model_dir = snapshot_download('okwinds/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit')
```
Git下载
```
#Git模型下载
git clone https://www.modelscope.cn/okwinds/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit.git
```
# 模型介绍
## 简介
MLX 是 Apple 机器学习研究团队,推出的一款针对 Apple silicon 芯片的机器学习 array framework。
#### MLX 的主要特性
- MLX提供了一个与NumPy紧密一致的Python API。MLX还提供了功能齐全的C++、C和Swift API,这些API与Python API高度相似。MLX拥有更高级别的包,如mlx.nn和mlx.optimizers,它们的API与PyTorch紧密一致,以简化构建更复杂模型的过程。
- 可组合函数变换:MLX支持可组合的函数变换,用于自动微分、自动向量化以及计算图优化。
- Lazy computation:MLX中的计算是惰性的。数组仅在需要时才会被实际创建。
- 动态图构建:MLX中的计算图是动态构建的。改变函数参数的形状不会触发缓慢的编译过程,调试过程简单直观。
- 多设备支持:操作可以在支持的任何设备上运行(目前包括CPU和GPU)。
- 统一内存模型:MLX与其它框架的主要区别在于其统一内存模型。在MLX中,数组存储在共享内存中,这意味着可以在任何支持的设备类型上执行操作,而无需在设备间传输数据。
#### 模型概述
DeepSeek-R1-Distill-Qwen-32B-MLX-6bit 是一个基于 [deepseek-ai/DeepSeek-R1-Distill-Qwen-32B](https://www.modelscope.cn/models/deepseek-ai/DeepSeek-R1-Distill-Qwen-32B) 的 6bit 量化的模型。
- **模型名称:** DeepSeek-R1-Distill-Qwen-32B-MLX-6bit
- **模型架构:** Qwen2.5
- **权重量化:** 6bit
该模型通过将 [deepseek-ai/DeepSeek-R1-Distill-Qwen-32B](https://www.modelscope.cn/models/deepseek-ai/DeepSeek-R1-Distill-Qwen-32B) 的 16bit 权重量化为 6bit 而实现。
量化过程将每个参数从 16bit 减少到 6bit,将模型占用磁盘空间大小,以及推理时加载模型需要的 MAC 内存空间,减少到了大约为原模型的40%左右。
> 注意:MLX 仅适用于运行 macOS >= 13.5 的设备,强烈建议使用 macOS 14 (Sonoma)
## 推理要求
运行以下命令以安装所需的 MLX 软件包。
```
pip install mlx-lm mlx -U
```
## Quickstart
#### 代码示例
这里提供了一个带有 `apply_chat_template` 的代码片段,展示如何加载 tokenizer 和模型以及如何生成内容。
```Python
from mlx_lm import load, generate
model_dir = "/Users/AI/Model/DeepSeek-R1-Distill-Qwen-32B-MLX-6bit"
model, tokenizer = load(model_dir, tokenizer_config={"eos_token": "<|end▁of▁sentence|>"})
prompt = "请出三道小学的奥数题,并给出正确答案"
messages = [
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True
)
response = generate(model, tokenizer, prompt=text, verbose=True, top_p=0.7, temp=0.6, repetition_penalty=1.2, max_tokens=2048)
```
推理结果样例:
```plaintext
==========
Prompt: <|begin▁of▁sentence|>You are a helpful assistant.<|User|>请出三道小学的奥数题,并给出正确答案<|Assistant|>
[Warning] Specifying sampling arguments to ``generate_step`` is deprecated. Pass in a ``sampler`` instead.
[Warning] Specifying ``repetition_penalty`` is deprecated. Pass in ``logits_processors`` instead.
好的,我现在要准备给用户出三道小学奥数题,并给出正确答案。首先,我需要确定这些题目适合小学阶段的学生,难度适中且有趣。
第一题可以是关于时间的问题。比如,钟表问题是一个不错的选择。假设现在的时间是3点15分,问再过多少分钟时针和分针会重合。这个问题需要计算两者的速度差,然后找出相遇的时间。
第二题可以是关于年龄的问题。比如,父亲和儿子的年龄差不变,当儿子12岁时,父亲36岁。现在儿子是48岁,问父亲多少岁?这个问题可以通过年龄差来解决。
第三题可以是一个逻辑推理的问题。比如,三个朋友A、B、C在说真话或谎话的情况下,判断谁是小偷。通过分析他们的话来确定答案。
接下来,我需要确保每道题都有详细的解答过程,并且正确性。第一题可以通过计算分针和时针的速度,找出相遇时间;第二题通过年龄差来确定父亲的当前年龄;第三题可以通过排除法找出说真话的人。
最后,我要确保答案清晰明了,并且适合小学生理解。可能还需要使用一些图形或表格来辅助解释,但这里只能用文字描述。
现在开始准备题目:
1. 时间问题:钟表显示3点15分,问再过多少分钟时针和分针会重合?
2. 年龄问题:父亲在儿子12岁时36岁,现在儿子48岁,问父亲多少岁?
3. 逻辑推理:A、B、C三个朋友中有一个小偷,只有一个人说真话。A说:“是B干的。” B说:“不是我做的,C做了。” C说:“ innocent.” 谁是小偷?
好的,现在准备答案:
1. 钟表问题:计算分针和时针的速度差,找出相遇时间。答案是15分钟。
2. 年龄问题:年龄差为24岁,现在儿子48岁时,父亲是72岁。
3. 逻辑推理:通过分析每个人的话,确定B说了假话,所以小偷是C。
这样三道题应该符合用户的要求。
好的!以下是一些适合小学奥数的题目和答案:
### 题目1:时间问题
**题目**: 现在的时间是3点15分,问再过多少分钟时针和分针会重合?
**解答**:
1. 分针每小时转360度,速度为6度/分钟。
2. 时针每小时转30度(因为一圈是12小时),速度为0.5度/分钟。
3. 在3点整时,分针在12的位置(0度),时针在9的位置(3×30=90度)。
4. 从3点15分开始,分针在15分钟内转了90度(因为每分钟6度)。
- 分针在3点15分的位置是90 + 15×6 = 180度。
- 此时,时针在3点整的位置是90度,在15分钟内转了7.5度(因为每小时60分钟,3点整时为90度)。
- 时针在15分钟后的位置是97.5度(因为3点整后,每分钟转0.5度)。
接下来计算两针何时重合:
- 设再过x分钟,分针和时针的位置相同。
- 分针在3点15分之后转过的角度:90 +6x
- 时针在3点15分之后转过的角度:90 +0.5x
- 当两针重合时,6x = (97.5 +0.5x) 或者 180度(因为分针可能在下一次重合时超过360度)
- 解方程:5.5x =180 → x=32又8/11分钟
**答案**: 再过32又8/11分钟,时针和分针会重合。
---
### 题目2:年龄问题
**题目**: 父亲在儿子12岁时36岁,现在儿子48岁,问父亲多少岁?
**解答**:
1. 父亲和儿子的年龄差是36 - 12 = 24岁。
2. 现在儿子48岁时,父亲的年龄是:48 + 24 =72岁。
**答案**: 父亲现在72岁。
---
### 题目3:逻辑推理
**题目**: 有三个朋友A、B、C,其中一个人偷了东西。他们三人中只有一个人说真话:
- A说:“是B干的。”
- B说:“不是我做的,C做了。”
- C说:“innocent.”
**解答**:
1. 假设A说的是真话,那么B是小偷。但这样C说的就是假话(因为如果A和B都是真话,那么只有一个人说了假话),这与题目条件矛盾。
2. 假设B说的是真话,那么C没做,且小偷不是自己。因此,A说的假话意味着B没有做,所以只能是C做了。
3. 因此,小偷是C。
**答案**: 小偷是C。
==========
Prompt: 23 tokens, 33.607 tokens-per-sec
Generation: 1202 tokens, 19.628 tokens-per-sec
Peak memory: 4.370 GB
```
#### 推理引擎
推荐在 MAC 上使用 xinference 进行推理,xinference 是一个一站式推理 LLM 的引擎,可以方便易用地加载和运行 MLX 模型。并且兼容 Openai 样式的 API,对 Qwen 系列模型支持 Function calling 推理。
使用 conda 创建一个虚拟环境,并安装 xinference :
```bash
# 创建 python 3.10 虚拟环境
conda create -n xinference python=3.10 -y
# 激活虚拟环境
conda activate xinference
# 安装 xinference 以及 mlx 依赖
pip install "xinference[mlx]"
```
启动 xinference:
```bash
xinference-local -H 0.0.0.0 -p 9997
```
启动后,可以通过http://localhost:9997 访问 xinference 的 web 界面。通过 Register Model 注册下载好的模型以后,即可推理。
---
以下引自原模型的Model Card
## 1. 引言
我们推出第一代推理模型 DeepSeek-R1-Zero 和 DeepSeek-R1。
DeepSeek-R1-Zero 是一种通过大规模强化学习(Reinforcement Learning, RL)训练的模型,训练过程中未使用监督微调(Supervised Fine-Tuning, SFT)作为前置步骤,但在推理任务上表现出色。
借助 RL,DeepSeek-R1-Zero 自然地展现出许多强大且有趣的推理行为。然而,DeepSeek-R1-Zero 也面临一些挑战,例如无休止的重复、可读性差以及语言混合等问题。
为解决这些问题并进一步提升推理性能,我们推出了 DeepSeek-R1,该模型在 RL 之前引入了冷启动数据(cold-start data)。
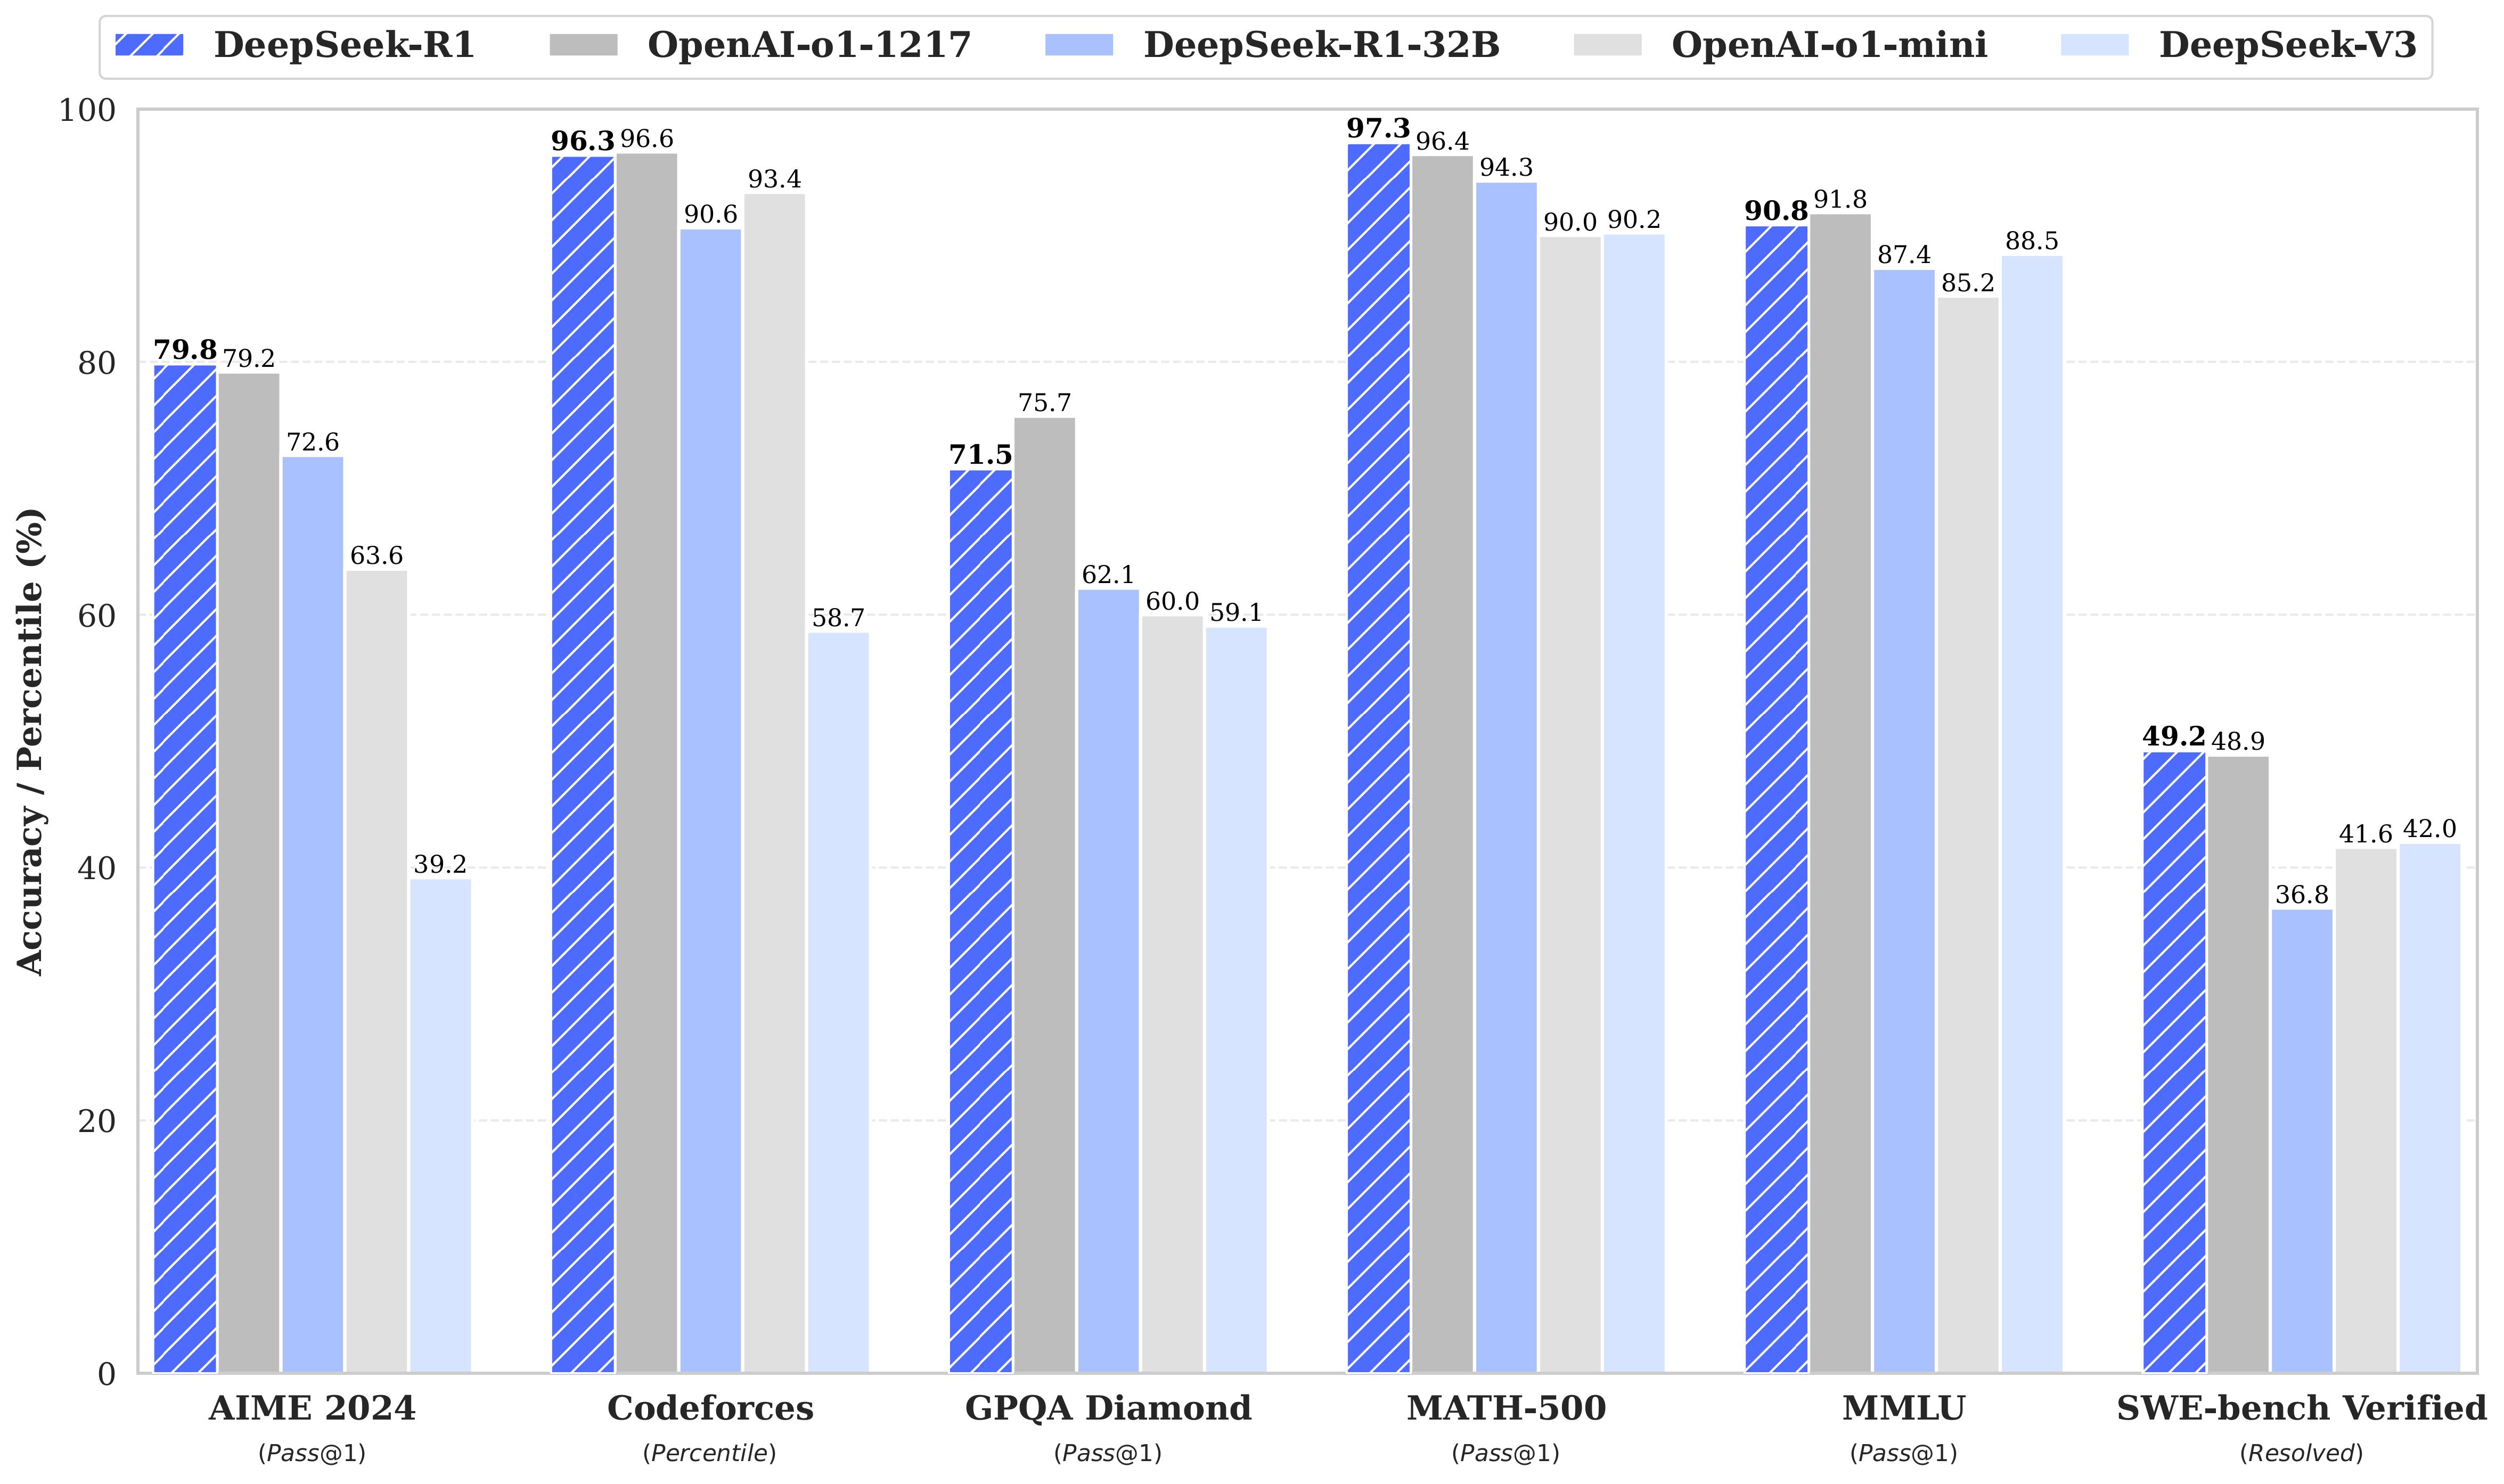
DeepSeek-R1 在数学、编程和推理任务上的表现与 OpenAI-o1 相当。
为了支持研究社区,我们开源了 DeepSeek-R1-Zero、DeepSeek-R1,以及基于 Llama 和 Qwen 系列从 DeepSeek-R1 蒸馏出的六个Dense模型。
其中,DeepSeek-R1-Distill-Qwen-32B 在多个基准测试中超越了 OpenAI-o1-mini,为密集模型创造了新的最佳性能。
## 2. 模型概述
后训练:在基础模型上进行大规模强化学习
- 我们直接在基础模型上应用强化学习(RL),而不依赖于监督微调(SFT)作为前置步骤。
这种方法使模型能够探索用于解决复杂问题的思维链(Chain-of-Thought, CoT),从而开发出 DeepSeek-R1-Zero。
DeepSeek-R1-Zero 展示了自我验证、反思和生成长思维链的能力,这标志着研究社区的一个重要里程碑。
值得注意的是,它是首次公开研究验证,通过纯 RL 激励大型语言模型(LLMs)的推理能力,无需 SFT。
这一突破为该领域的未来发展铺平了道路。
- 我们介绍了开发 DeepSeek-R1 的流程。该流程包括两个 RL 阶段,旨在发现改进的推理模式并符合人类偏好,以及两个 SFT 阶段,作为模型推理和非推理能力的种子。
我们相信这一流程将有助于行业开发更好的模型。
蒸馏:小模型也可以很强大
- 我们证明了可以将大模型的推理模式蒸馏到小模型中,与通过小模型上的 RL 发现的推理模式相比,性能更好。开源的 DeepSeek-R1 及其 API 将有助于研究社区在未来蒸馏出更好的小模型。
- 使用 DeepSeek-R1 生成的推理数据,我们微调了几个在研究社区中广泛使用的密集模型。评估结果表明,这些蒸馏后的小密集模型在基准测试中表现出色。我们基于 Qwen2.5 和 Llama3 系列开源了 1.5B、7B、8B、14B、32B 和 70B 的检查点,供社区使用。
DeepSeek-R1-Distill 模型是基于开源模型微调的,使用 DeepSeek-R1 生成的样本进行训练。我们对其配置和分词器进行了小幅调整。请使用我们的设置运行这些模型。
## 3. 评估结果
DeepSeek-R1 评估
对于所有模型,最大生成长度设置为 32,768 个Token。对于需要采样的基准测试,我们使用温度为 0.6、top-p 值为 0.95,并为每个查询生成 64 个响应以估计 pass@1。
| Category | Benchmark (Metric) | Claude-3.5-Sonnet-1022 | GPT-4o 0513 | DeepSeek V3 | OpenAI o1-mini | OpenAI o1-1217 | DeepSeek R1 |
|----------|-------------------|----------------------|------------|--------------|----------------|------------|--------------|
| | Architecture | - | - | MoE | - | - | MoE |
| | # Activated Params | - | - | 37B | - | - | 37B |
| | # Total Params | - | - | 671B | - | - | 671B |
| English | MMLU (Pass@1) | 88.3 | 87.2 | 88.5 | 85.2 | **91.8** | 90.8 |
| | MMLU-Redux (EM) | 88.9 | 88.0 | 89.1 | 86.7 | - | **92.9** |
| | MMLU-Pro (EM) | 78.0 | 72.6 | 75.9 | 80.3 | - | **84.0** |
| | DROP (3-shot F1) | 88.3 | 83.7 | 91.6 | 83.9 | 90.2 | **92.2** |
| | IF-Eval (Prompt Strict) | **86.5** | 84.3 | 86.1 | 84.8 | - | 83.3 |
| | GPQA-Diamond (Pass@1) | 65.0 | 49.9 | 59.1 | 60.0 | **75.7** | 71.5 |
| | SimpleQA (Correct) | 28.4 | 38.2 | 24.9 | 7.0 | **47.0** | 30.1 |
| | FRAMES (Acc.) | 72.5 | 80.5 | 73.3 | 76.9 | - | **82.5** |
| | AlpacaEval2.0 (LC-winrate) | 52.0 | 51.1 | 70.0 | 57.8 | - | **87.6** |
| | ArenaHard (GPT-4-1106) | 85.2 | 80.4 | 85.5 | 92.0 | - | **92.3** |
| Code | LiveCodeBench (Pass@1-COT) | 33.8 | 34.2 | - | 53.8 | 63.4 | **65.9** |
| | Codeforces (Percentile) | 20.3 | 23.6 | 58.7 | 93.4 | **96.6** | 96.3 |
| | Codeforces (Rating) | 717 | 759 | 1134 | 1820 | **2061** | 2029 |
| | SWE Verified (Resolved) | **50.8** | 38.8 | 42.0 | 41.6 | 48.9 | 49.2 |
| | Aider-Polyglot (Acc.) | 45.3 | 16.0 | 49.6 | 32.9 | **61.7** | 53.3 |
| Math | AIME 2024 (Pass@1) | 16.0 | 9.3 | 39.2 | 63.6 | 79.2 | **79.8** |
| | MATH-500 (Pass@1) | 78.3 | 74.6 | 90.2 | 90.0 | 96.4 | **97.3** |
| | CNMO 2024 (Pass@1) | 13.1 | 10.8 | 43.2 | 67.6 | - | **78.8** |
| Chinese | CLUEWSC (EM) | 85.4 | 87.9 | 90.9 | 89.9 | - | **92.8** |
| | C-Eval (EM) | 76.7 | 76.0 | 86.5 | 68.9 | - | **91.8** |
| | C-SimpleQA (Correct) | 55.4 | 58.7 | **68.0** | 40.3 | - | 63.7 |
蒸馏模型评估
| Model | AIME 2024 pass@1 | AIME 2024 cons@64 | MATH-500 pass@1 | GPQA Diamond pass@1 | LiveCodeBench pass@1 | CodeForces rating |
|------------------------------------------|------------------|-------------------|-----------------|----------------------|----------------------|-------------------|
| GPT-4o-0513 | 9.3 | 13.4 | 74.6 | 49.9 | 32.9 | 759 |
| Claude-3.5-Sonnet-1022 | 16.0 | 26.7 | 78.3 | 65.0 | 38.9 | 717 |
| o1-mini | 63.6 | 80.0 | 90.0 | 60.0 | 53.8 | **1820** |
| QwQ-32B-Preview | 44.0 | 60.0 | 90.6 | 54.5 | 41.9 | 1316 |
| DeepSeek-R1-Distill-Qwen-1.5B | 28.9 | 52.7 | 83.9 | 33.8 | 16.9 | 954 |
| DeepSeek-R1-Distill-Qwen-7B | 55.5 | 83.3 | 92.8 | 49.1 | 37.6 | 1189 |
| DeepSeek-R1-Distill-Qwen-14B | 69.7 | 80.0 | 93.9 | 59.1 | 53.1 | 1481 |
| DeepSeek-R1-Distill-Qwen-32B | **72.6** | 83.3 | 94.3 | 62.1 | 57.2 | 1691 |
| DeepSeek-R1-Distill-Llama-8B | 50.4 | 80.0 | 89.1 | 49.0 | 39.6 | 1205 |
| DeepSeek-R1-Distill-Llama-70B | 70.0 | **86.7** | **94.5** | **65.2** | **57.5** | 1633 |
## 4. 聊天网站和 API 平台
您可以在 DeepSeek 官方网站 chat.deepseek.com 上与 DeepSeek-R1 进行对话,并打开 “深度思考” 按钮。
我们还在 DeepSeek 平台提供 OpenAI 兼容的 API:platform.deepseek.com。
## 5. 如何本地运行
DeepSeek-R1 模型
请访问 DeepSeek-V3 仓库,了解有关本地运行 DeepSeek-R1 的更多信息。
DeepSeek-R1-Distill 模型
DeepSeek-R1-Distill 模型的使用方式与 Qwen 或 Llama 模型相同。
例如,您可以使用 vLLM 轻松启动服务:
```Shell
vllm serve deepseek-ai/DeepSeek-R1-Distill-Qwen-32B --tensor-parallel-size 2 --max-model-len 32768 --enforce-eager
```
注意:我们建议在运行这些模型时设置适当的温度(0.5 到 0.7 之间),否则您可能会遇到无休止的重复或不连贯的输出问题。
6. 许可
本代码仓库和模型权重均在 MIT License 下授权。DeepSeek-R1 系列支持商业用途,允许进行任何修改和衍生作品,包括但不限于用于训练其他大型语言模型(LLMs)的蒸馏。请注意:
- DeepSeek-R1-Distill-Qwen-1.5B、DeepSeek-R1-Distill-Qwen-7B、DeepSeek-R1-Distill-Qwen-14B 和 DeepSeek-R1-Distill-Qwen-32B 均基于 Qwen-2.5 系列,最初在 Apache 2.0 License 下授权,现已使用 DeepSeek-R1 精选的 800k 样本进行微调。
- DeepSeek-R1-Distill-Llama-8B 基于 Llama3.1-8B-Base,最初在 llama3.1 许可证 下授权。
- DeepSeek-R1-Distill-Llama-70B 基于 Llama3.3-70B-Instruct,最初在 llama3.3 许可证 下授权。