---
title: firefly-pretrain-dataset
canonical_url: "https://www.modelscope.cn/datasets/YeungNLP/firefly-pretrain-dataset"
md_url: "https://www.modelscope.cn/datasets/YeungNLP/firefly-pretrain-dataset.md"
repository: YeungNLP/firefly-pretrain-dataset
last_updated: 2023-10-25
license: "Apache License 2.0"
storage_size: "21 GB"
domain:
- source_datasets
tasks:
- original
downloads: 2490
stars: 22
---
# firefly-pretrain-dataset
> firefly-pretrain-dataset - YeungNLP 在 ModelScope 开源的数据集。Firefly中文Llama2增量预训练数据
YeungNLP/firefly-pretrain-dataset 是 ModelScope 魔搭社区上的original数据集,涉及 source_datasets 领域,存储大小 21 GB,采用 Apache License 2.0 许可。
- **Repository**: YeungNLP/firefly-pretrain-dataset
- **License**: Apache License 2.0
- **Tasks**: original
- **Domain**: source_datasets
- **Storage size**: 21 GB
- **Downloads**: 2490
- **Stars**: 22
- **Last updated**: 2023-10-25
Source: https://www.modelscope.cn/datasets/YeungNLP/firefly-pretrain-dataset
---
# Firefly中文Llama2增量预训练数据
 欢迎加入Firefly大模型技术交流群,关注我们的公众号。
 ## 数据简介
技术文章:[QLoRA增量预训练与指令微调,及汉化Llama2的实践](https://mp.weixin.qq.com/s/26-Qxma9M2wGoTQgOlKRmQ)
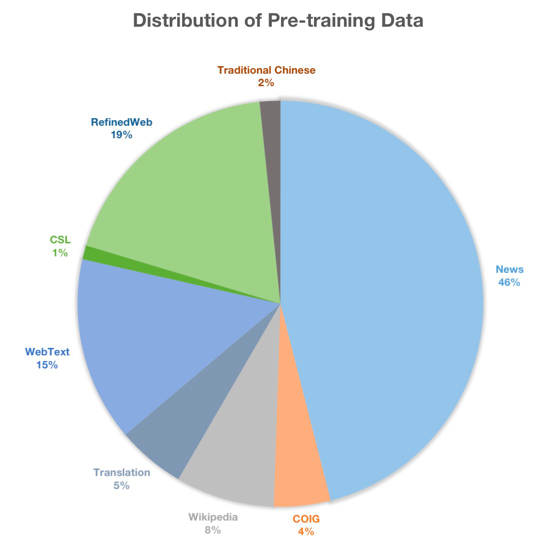
该数据应为[Firefly-LLaMA2-Chinese项目](https://github.com/yangjianxin1/Firefly-LLaMA2-Chinese)的增量预训练数据,一共约22GB文本,主要包含CLUE、ThucNews、CNews、COIG、维基百科等开源数据集,以及我们收集的古诗词、散文、文言文等,数据分布如下图。
 ## 模型列表 & 数据列表
我们开源了7B和13B的Base与Chat模型。Base模型是基于LLaMA2扩充中文词表后增量预训练得到的模型,Chat模型是在Base模型的基础上进行多轮对话指令微调。
为了探究基座模型对指令微调的影响,我们也微调了baichuan2-base模型,获得firefly-baichuan2-13b,具有不错的效果。更多中文微调,可查看[Firefly项目](https://github.com/yangjianxin1/Firefly)。
| 模型 | 类型 | 训练任务 | 训练长度 |
|-----------------------------------------------------------------------------------------------|------|--------|------|
| 🤗[Firefly-LLaMA2-7B-Base](https://modelscope.cn/models/YeungNLP/firefly-llama2-7b-base) | 基座模型 | CLM | 1024 |
| 🤗[Firefly-LLaMA2-13B-Base](https://modelscope.cn/models/YeungNLP/firefly-llama2-13b-base) | 基座模型 | CLM | 1024 |
| 🤗[Firefly-LLaMA2-7B-Chat](https://modelscope.cn/models/YeungNLP/firefly-llama2-7b-chat) | 指令模型 | 多轮指令微调 | 1024 |
| 🤗[Firefly-LLaMA2-13B-Chat](https://modelscope.cn/models/YeungNLP/firefly-llama2-13b-chat) | 指令模型 | 多轮指令微调 | 1024 |
| 🤗[Firefly-Baichuan2-13B](https://modelscope.cn/models/YeungNLP/firefly-baichuan2-13b) | 指令模型 | 多轮指令微调 | 1024 |
## 模型评测
我们在CMMLU和Open LLM Leaderboard上分别对模型的中文和英文能力进行了客观评测,并且在我们构建的人工评测集上进行了人工评测。
**Open LLM Leaderboard和CMMLU榜单倾向于评测大模型的做题能力,不够全面,所以我们进一步进行了人工评测。**
### Open LLM Leaderboard
| 模型 | Average | ARC | HellaSwag | MMLU | TruthfulQA |
|-----------------------------|-----------|-------|-----------|-------|------------|
| chinese-alpaca-2-13b | 60.94 | 58.7 | 79.74 | 55.1 | 50.22 |
| openbuddy-llama2-13b-v8.1 | 60.47 | 55.97 | 79.79 | 54.95 | 51.16 |
| flagalpha-llama2-13b-chat | 60.41 | 55.97 | 82.05 | 54.74 | 48.9 |
| llama-2-13b-chat | 59.93 | 59.04 | 81.94 | 54.64 | 44.12 |
| vicuna-13b-v1.1 | 59.22 | 52.73 | 80.13 | 51.94 | 52.08 |
| guanaco-13b | 59.18 | 57.85 | 83.84 | 48.28 | 46.73 |
| **firefly-llama2-13b-chat** | **59.05** | 57.51 | 77.94 | 52.56 | 48.18 |
| llama-2-7b-chat | 56.34 | 52.9 | 78.55 | 48.32 | 45.57 |
| flagalpha-llama2-7b-chat | 56.13 | 52.39 | 77.52 | 47.72 | 46.87 |
| yayi-7b-llama2 | 54.45 | 55.03 | 77.84 | 40.92 | 44.02 |
| chinese-alpaca-2-7b | 54.33 | 49.57 | 72.62 | 46.5 | 48.63 |
| **firefly-llama2-7b-chat** | **54.19** | 51.19 | 73.32 | 45.47 | 46.78 |
| yayi-13b-llama2 | 51.06 | 48.55 | 74.82 | 38.68 | 42.19 |
| linly-llama2-7b | 49.06 | 48.04 | 73.25 | 35.04 | 39.92 |
| linly-llama2-13b | 38.22 | 33.62 | 39.59 | 33.97 | 45.71 |
| ziya-llama-13b* | - | - | 76.9 | 50.3 | - |
*表示分数来源于OpenCompass官方,而非Open LLM Leaderboard官方数据
Conclusion:我们的模型保留了llama2模型优秀的英文能力,在Open LLM Leaderboard上,与llama2-chat、vicuna-v1.1、guanaco等模型的表现及其接近。
### CMMLU榜单
| 模型 | CMMLU | 训练细节 |
|-----------------------------|-----------|------------------------|
| **firefly-baichuan2-13b** | **56.83** | 4\*V100,QLoRA,指令微调 |
| chinese-alpaca-2-13b | 45.17 | 48\*A40,LoRA,词表扩充 + 增量预训练 + 指令微调 |
| openbuddy-llama2-13b-v8.1 | 41.66 | 全量参数训练,词表扩充 + 指令微调 |
| chinese-alpaca-2-7b | 40.86 | 48\*A40,LoRA,词表扩充 + 增量预训练 + 指令微调 |
| ziya-llama-13b* | 39.9 | 160\*A100,全量参数训练,词表扩充 + 增量预训练 + 指令微调 + RLHF |
| chinese-alpaca-plus-13b* | 39.9 | 48\*A40,LoRA,词表扩充 + 增量预训练 + 指令微调 |
| **firefly-llama2-13b-chat** | **39.47** | 4\*V100,QLoRA,词表扩充 + 增量预训练 + 指令微调 |
| flagalpha-llama2-13b-chat | 39.20 | LoRA,指令微调 |
| llama-2-13b-chat | 38.65 | 全量参数训练,预训练 + 指令微调 + RLHF(全流程为英文) |
| **firefly-llama2-7b-chat** | **34.03** | 4\*V100,QLoRA,词表扩充 + 增量预训练 + 指令微调 |
| llama-2-7b-chat | 33.76 | 全量参数训练,预训练 + 指令微调 + RLHF(全流程为英文) |
| flagalpha-llama2-7b-chat | 32.61 | LoRA,指令微调 |
| chinese-alpaca-plus-7b* | 32.6 | 48\*A40,LoRA,词表扩充 + 增量预训练 + 指令微调 |
| yayi-13b-llama2 | 30.73 | 指令微调 |
| yayi-7b-llama2 | 30.47 | 指令微调 |
| linly-llama2-7b | 28.68 | 32\*A100,全量参数训练,词表扩充 + 混合训练 |
| linly-llama2-13b | 26.32 | 32\*A100,全量参数训练,词表扩充 + 混合训练 |
我们统一采用OpenCompass工具来离线评测CMMLU,其中*表示结果来源于OpenCompass官方榜单或者由模型作者自测的分数。
Conclusions:
- 与llama-2-chat相比,我们的模型在中文方面的能力具有一定的提升。
- 对于中文词表扩充模型而言,我们的模型大幅领先全量训练的linly,与全量训练的ziya、chinese-alpaca-1及其接近。
- firefly-baichuan2-13b一骑绝尘,并且在OpenCompass的CMMLU榜单,该分数可排第8,小幅落后于百川官方模型,进一步验证了基座模型的重要性。
- 我们的模型在CMMLU上的指标与chinese-alpaca-2也存在一定的差距。这一现象很大程度与增量预训练数据量和数据分布相关,我们的增量预训练数据仅为22GB(未充分使用,详情见训练细节),增量预训练不够充分,且大部分为新闻语料,对于CMMLU能力的提升有限。
### 人工评测
我们构建了评测集,其中包含13种评测任务,评测数据详见data/firefly-eval.xlsx。大部分数据从[Belle数据](https://huggingface.co/datasets/BELLE-2/train_3.5M_CN_With_Category)中进行采样和优化。
每种任务包含10条数据,一共130条数据。13种任务包含:头脑风暴、分类、Close QA、代码生成、
信息抽取、开放式生成、有害性检验、数学题、阅读理解、Open QA、Rewrite、Summarization、翻译。
评测标准如下:
- 对于同一道题目,对两两模型的生成结果进行比较,存在胜负平三种关系。
- 对于客观题,如果两个模型均回答正确,或均回答错误,则为平局。
- 对于主观题,回答更加详细、真实、细节更丰富,则为获胜。当两者内容正确,并且详细程度非常接近时,或者各有千秋时,可视为平局。
- 对于中文题目,如果目标回复为中文,但模型却回复英文,则判为错误。
详细的评测结果可参考:[人工评测结果](https://docs.qq.com/sheet/DU1h1bE1xWG50ZVlI?tab=BB08J2)。在评测中,我们遵守设定的评测标准,但依旧难以完全避免主观因素的影响,
本着公开透明的原则,我们公开了评测细节,大家可比较模型效果。
同为基于LLaMA2进行汉化的模型,我们对Firefly-LLaMA2-13B-Chat和Linly-LLaMA2-13B进行了人工测评,从评测结果来看,我们的模型存在非常大的优势。
并且我们与Llama2-Chat-13B也进行了人工评测,也存在非常大的优势。
| 模型 | 获胜 | 平局 | 失败 |
|---------------------------------------------|------|------------|----------|
| Firefly-LLaMA2-13B-Chat VS Linly-LLaMA2-13B | **43(33.08%)** | 79(60.77%) | 8(6.15%) |
| Firefly-LLaMA2-13B-Chat VS Llama2-Chat-13B | **86(66.15%)** | 40(30.77%) | 4(3.08%) |